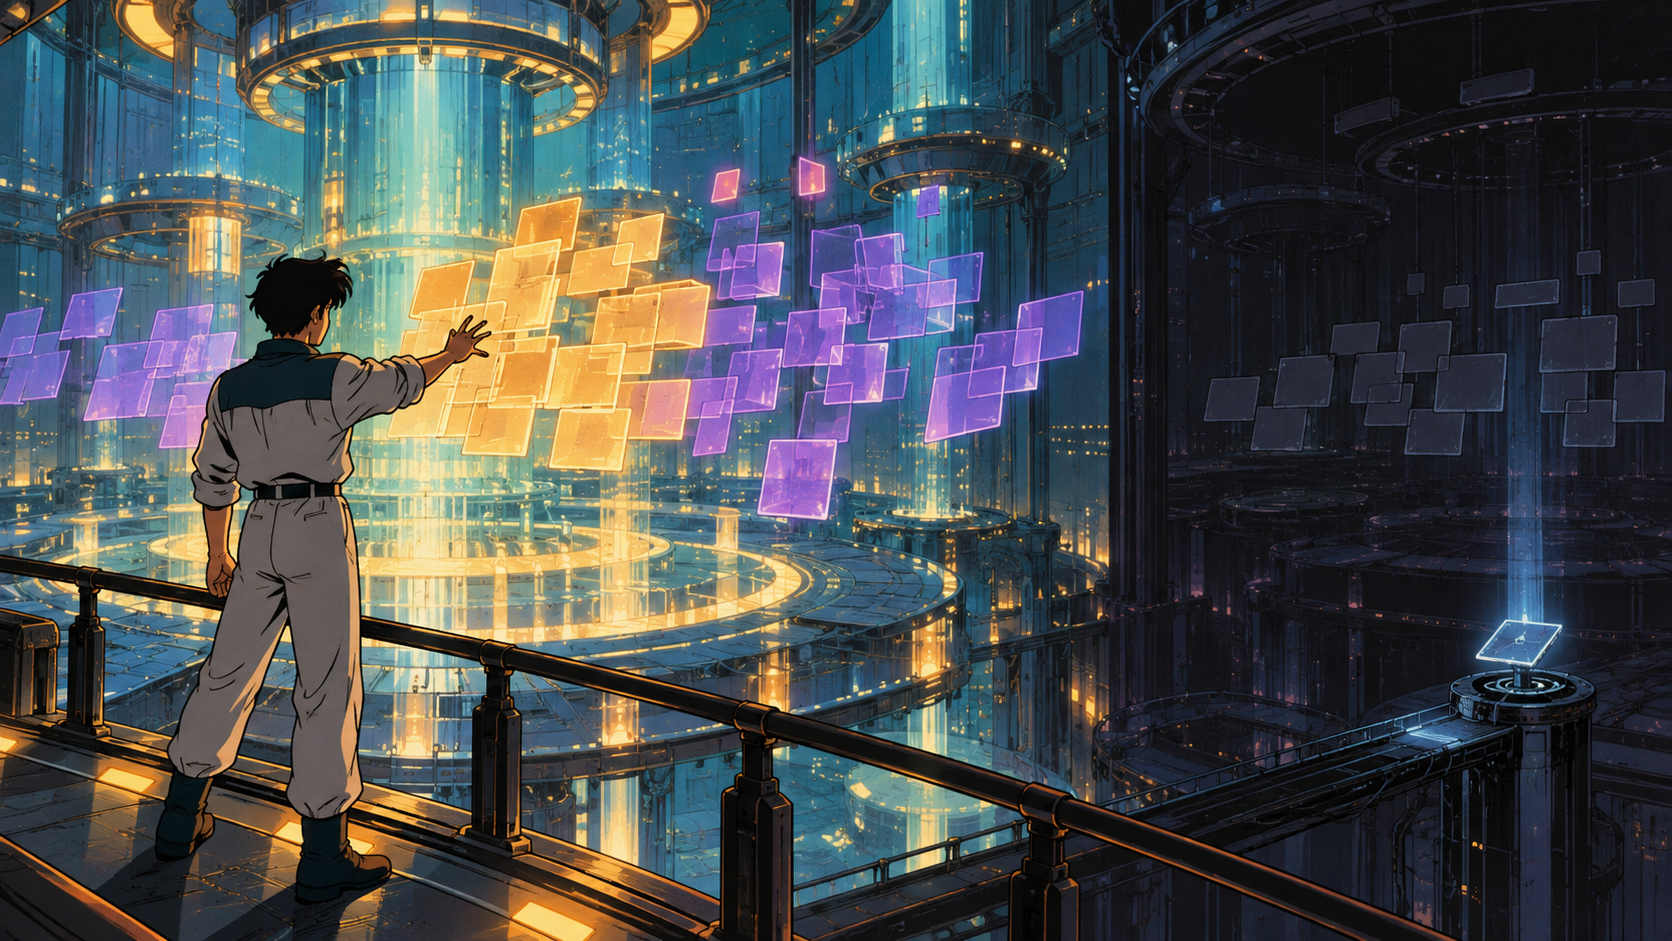
확정한 타일과 아직 계산할 타일을 구분하며 장치의 가동 범위를 조절하는 엔지니어

필요한 계산을 고르는 에이전트: Diffusion 언어모델의 메타인지 디코딩

검색 도구를 호출하는 에이전트를 생각해 보겠습니다. 검색 요청이 완성되면 다음 판단에 필요한 것은 검색 결과입니다. 그런데 생성기가 그 뒤의 텍스트까지 계산하고 실행 환경은 그 내용을 버린다면, 계산을 많이 했어도 작업에는 도움이 되지 않습니다. 이 상황은 설명을 위한 예시입니다. 앞서 Prefix-aware Routing 글에서는 이미 계산한 입력을 재사용할 서버를 선택하는 문제를 다뤘습니다. 이번에는 생성 중인 응답 안에서 어떤 계산을 계속할지 살펴보겠습니다. 토큰 확정과 계산 범위를 함께 조절합니다 Diffusion 언어모델을 이해하는 출발점은 아직 정하지 않은 토큰 위치를 여러 번 예측하며 채워 간다는 점입니다. 여러 위치를 병렬로 처리할 수 있지만, 반복 계산이 필요합니다. 블록 단위 생성에서는 이런 작업을 일정한 구간 안에서 수행합니다. 따라서 병렬 생성에서도 계산 횟수와 계산할 위치의 수를 함께 살펴봐야 합니다. ...
2026년 11월 2일 · 4 분 · Jesam Kim
Claude Opus 4.7 새 capabilities

Claude Opus 4.7 들여다보기 — 새 capabilities가 만드는 차이

2026년 4월 16일, Anthropic이 Claude Opus 4.7을 공개했습니다. 같은 날 GitHub Copilot, Cursor, Claude Code가 일제히 지원을 시작했습니다. 가격은 Opus 4.6과 동일한 입력 $5 / MTok, 출력 $25 / MTok이고 모델 ID는 claude-opus-4-7입니다. 1M 컨텍스트와 128k max output은 유지됐습니다. 가격이 그대로면 보통은 숫자만 바뀐 업데이트로 흘려보내기 쉽습니다. 그런데 이번 릴리즈는 숫자보다 파라미터의 문법 자체가 바뀐 편입니다. thinking 인터페이스가 바뀌었고, 새 파라미터 두 개가 추가됐고, 비전 해상도가 3.3배가 됐습니다. 프로덕션에서 Opus 4.6을 쓰고 있었다면 코드 몇 군데는 반드시 손봐야 합니다. ...

2026년 5월 2일 · 8 분 · Jesam Kim

Enterprise LLM을 프로덕션에 올리기 위한 설계 패턴

Enterprise 환경에서 LLM 기반 시스템을 프로덕션에 배포하려면, 단순히 API를 호출하는 것 이상의 설계가 필요합니다. PoC에서는 잘 동작하던 시스템이 실제 트래픽과 다양한 질의를 만나면 hallucination, 검색 품질 저하, 보안 취약점 같은 문제가 수면 위로 올라옵니다. 이 글에서는 Enterprise LLM 시스템을 설계할 때 반복적으로 등장하는 5가지 핵심 패턴을 정리합니다. 각 패턴은 독립적으로 적용할 수도 있고, 하나의 시스템 안에서 조합할 수도 있습니다. 1. Enterprise RAG: 검색 품질이 답변 품질을 결정합니다 RAG(Retrieval-Augmented Generation)는 LLM이 외부 지식을 참조해서 답변을 생성하는 기법입니다. 원리 자체는 단순하지만, 5만 건 이상의 내부 문서를 다루는 Enterprise 환경에서는 설계 난이도가 급격히 올라갑니다. ...

2026년 3월 22일 · 10 분 · Jesam Kim
Some illustrations are generated using Amazon Bedrock image generation models (Nova 2 Omni, SD3.5 Large, Nova Canvas).