에이전트가 도구를 호출하기 전에는 작은 판단이 반복됩니다. 문의를 어느 담당자에게 보낼지, 도구 인자를 사용자가 실제로 말했는지, 추가 질문이 필요한지 결정해야 합니다. 이런 단계에는 긴 답변보다 프로그램이 바로 읽을 선택지와 확률이 유용합니다.
AWS Strands 팀은 2026년 10월 1일, 이런 용도를 위한 Strands Decider 2B를 공개했습니다. 로컬 CPU나 GPU에서 실행할 수 있고, 모델 구성과 학습 방법을 살펴보며 수정할 수 있는 판단 모델입니다. TypeSafe의 Jev와 같은 종류의 문제를 다루며, Jev가 관리형 API로 제공되는 데 비해 Decider는 개발자가 직접 모델을 배포하고 운영합니다.
앞선 Jev 글에서는 입력 자료인 state와 Choice, Noul, Score를 설명했습니다. 이번에는 Decider의 내부 구조, Jev API를 대체할 때 확인할 차이, 직접 실행한 결과에 집중합니다. 문서와 모델 정보는 2026년 10월 7일 기준입니다.
LM head를 pointer head로 바꾼 모델 구조
Decider는 사전 학습한 Qwen3.5-2B-Base를 바탕으로 만듭니다. 일반적인 언어 모델은 입력을 처리한 뒤 LM head에서 다음 토큰을 고릅니다. Decider는 이 출력부를 제거하고 주어진 선택지에 점수를 매기는 pointer head를 붙입니다. 모델 본체는 rank-16 LoRA로 조정합니다.
입력에는 상황, 질문, 선택지 설명이 함께 들어갑니다. 모델이 이 입력을 처리하면 각 위치에 문맥을 반영한 벡터가 생깁니다. Pointer head는 답변 위치의 벡터와 각 선택지 끝의 벡터를 비교해 점수를 구하고, softmax로 선택지별 분포를 만듭니다. 답변 문장을 한 토큰씩 생성하는 반복 과정은 없습니다.
참조: 공개 아키텍처 설명

공식 저장소의 원본 구조도입니다. 왼쪽은 일반적인 언어 모델, 오른쪽은 선택지에 점수를 매기는 Decider입니다. 그림에서 사용하는 Hobson은 체크포인트 이름에도 쓰입니다. 그림을 누르면 크게 볼 수 있습니다.
참조: Strands Decider 원본 그림, Apache-2.0

이 방식에서는 분류할 이름과 설명을 요청할 때 전달할 수 있습니다. 분류 범주를 학습 시점에 고정할 필요가 없습니다. 다만 새로 추가한 범주를 정확하게 구분하는지는 따로 평가해야 합니다. 공개 평가 문서도 낯선 yes/no 질문과 새로운 평가 기준에서 성능이 떨어질 수 있다고 설명합니다.
참조: 구조와 동적 선택지, 평가와 알려진 한계
직접 호스팅하는 Decider와 API로 사용하는 Jev
| 비교 항목 | Strands Decider | Jev |
|---|---|---|
| 사용 방식 | 공개 모델을 내려받아 로컬 또는 자체 인프라에서 실행 | TypeSafe의 관리형 API 호출 |
| 모델 공개 범위 | 베이스 모델, LoRA, 출력부, 학습 레시피와 데이터 출처 확인 가능 | 확인한 공식 자료에서 가중치와 상세 구조의 공개 자료를 찾지 못함 |
| 수정 방법 | 모델과 서빙 코드를 수정하고 재학습 가능 | 요청의 state, 질문과 선택지 설명을 조정 |
| 이 글의 비교 버전 | 발표 당시 v19와 이후 공개된 v21 | 공식 문서의 jev-1.13.0 |
| 입력 길이 제한 | 이번 실험의 Context Window 설정은 4,096토큰 | 요청 전체 64k, state와 가장 긴 질문의 합 32k |
| 비용 산정 | 장비 이용 시간, 실제 처리량, 유휴 시간, 운영 비용 | 입력 100만 토큰당 0.042달러, 출력 무료 |
| 직접 관리할 항목 | 배포, 인증, 용량, 장애 대응, 모델 업데이트 | API 연동, 한도와 오류 처리, 버전 및 품질 관리 |
참조: Decider 모델 카드, 서빙 문서, Jev 모델과 가격, Jev 학습 개념 설명
Decider를 자체 환경에 배포하면 판단에 사용하는 데이터를 외부 API로 보내지 않고 처리할 수 있습니다. 답변을 만드는 LLM이나 외부 도구도 사용한다면, 그쪽으로 어떤 데이터가 전달되는지는 별도로 확인해야 합니다. Jev에서는 TypeSafe가 모델을 서빙하므로 사용자가 모델을 설치하거나 GPU 용량을 관리할 필요가 없습니다.
공개 모델을 무료로 내려받는다는 사실만으로 요청당 비용이 Jev보다 낮다고 결론낼 수는 없습니다. 같은 장비에서도 사용률과 요청 크기에 따라 비용이 달라집니다. 이 글의 실험은 이미 실행 중인 GPU를 사용하므로 새 인스턴스를 생성하지 않았지만, 장비 이용 비용까지 없어지는 것은 아닙니다.
Jev도 SDK와 워크플로 평가 코드를 공개합니다. TypeSafe의 WorkflowEvals로는 API 기반 평가를 재현할 수 있습니다. Decider는 여기에 더해 모델 가중치와 학습 코드도 공개합니다.
참조: TypeSafe WorkflowEvals, Decider 학습 레시피
API 호환성, 입력 길이, confidence의 차이
두 모델은 state와 questions를 받고 Choice, Noul, Score를 반환하는 형태가 비슷합니다. Decider의 로컬 서버도 /v1/systemone을 제공합니다. 하지만 공개 서빙 문서는 Jev API 자체와의 호환성을 검증하지 않았다고 명시합니다. JevBench 어댑터로 평가를 실행할 수는 있지만, 기존 Jev SDK 코드가 Decider에서도 그대로 동작하는지는 별도 확인이 필요합니다.
Decider의 Context Window는 추론 시 입력 토큰 수의 상한입니다. 이 글의 GPU 실험에서는 이를 4,096토큰으로 설정했습니다. 기본 동작은 입력이 이 한도를 넘으면 질문의 선택지를 보존하면서 state를 줄이는 것입니다. --strict-window를 사용하면 입력을 자르는 대신 오류를 반환합니다. 정책 문서나 긴 대화를 분류할 때는 원문 일부가 빠진 상태로 판단한 것은 아닌지 확인해야 합니다.
참조: HTTP 서버와 Context Window 처리
confidence라는 필드명도 뜻을 확인해야 합니다. Choice에서는 두 구현 모두 가장 높은 선택지 확률을 균등분포 기준으로 정규화합니다. 예를 들어 선택지가 3개이고 가장 높은 확률이 0.6이면 confidence는 0.4입니다. 따라서 confidence 0.9를 곧바로 “이 답이 맞을 확률 90%”로 읽을 수 없습니다.
Score의 계산법에는 차이가 있습니다. Jev 문서는 가장 가능성이 높은 수준으로부터의 평균 절대거리를 사용합니다. Decider는 표준편차를 이용하며 학습 시 적용한 ordinal smoothing도 보정합니다. 기존 Score 임계값을 같은 숫자로 복사하면 처리 결과가 달라질 수 있습니다. 모델을 바꿀 때에는 업무 데이터로 임계값을 다시 평가해야 합니다.
참조: Jev confidence 계산식, Decider의 Choice와 Score 계산법
v19와 v21의 공개 평가 결과
발표 글의 모델은 v19이며, 10월 7일 확인한 공식 저장소에는 v21도 안내돼 있습니다. 아래는 각 모델 카드에 기록된 공개 배포 파일의 JevBench 평가입니다. 두 모델 모두 Context Window를 4,096토큰으로 설정한 결과입니다.
| 체크포인트 | 공개 과제 정답 수 | 정확도 | Brier score |
|---|---|---|---|
| v19 | 167 / 231 | 72.3% | 0.348 |
| v21 | 176 / 231 | 76.2% | 0.323 |
참조: v19 모델 카드의 Results, v21 모델 카드의 Results와 선택 방법
Brier score는 예측한 확률과 실제 정답의 차이를 평가하며, 이 표에서는 낮을수록 좋습니다. 다만 표의 두 줄은 각각 한 체크포인트의 결과입니다. v21 모델 카드는 별도 호스트에서 두 학습 레시피를 각각 6개 시드로 반복했을 때 평균 정답 수가 v19 172.8개, v21 설정 172.3개였다고 기록합니다. 카드 자체도 두 배포본의 차이를 그대로 정확도 향상으로 해석하지 말라고 설명합니다. v19의 레시피 평가 문서와 배포 파일의 모델 카드에도 서로 다른 측정값이 있으므로 출처를 섞지 않았습니다.
Jev의 공식 평가 결과는 이 표에 넣지 않았습니다. Decider가 사용하는 JevBench 공개 과제와 TypeSafe의 공식 WorkflowEvals는 평가 대상과 방식이 다르기 때문입니다. 후자는 네 업무 흐름에서 참조 모델의 결과와 얼마나 일치하는지 평가하므로, 두 평가의 정확도를 직접 비교할 수 없습니다.
참조: Decider의 JevBench 평가 범위, TypeSafe 공식 평가
발표 글의 RTX 3090 중앙값 약 115ms도 측정 조건이 있는 수치입니다. 같은 글의 지연 그래프는 v18 결과라고 적혀 있습니다. 이를 아래 GPU 실험이나 Jev의 API 지연과 합쳐 모델 간 속도 순위를 만들지는 않았습니다.
GPU 실험: 문의 분류와 부정 표현
메모리 24GB인 GPU 한 대에서 v19와 v21을 실행했습니다. BF16을 사용하고 Context Window를 4,096토큰으로 설정했으며, 요청마다 질문 하나를 전달했습니다. 소스 커밋과 Hugging Face의 모델 revision을 고정했고, Python 3.13.12, PyTorch 2.10.0, Transformers 5.17.0 환경에서 FLA와 causal-conv1d의 최적화 구현이 선택됐는지 확인했습니다. Jev API는 이번에 실행하지 않았습니다.
입력과 정답, 판정 기준은 첫 추론 전에 고정했습니다. 분류 실험에는 결제, 기술 지원, 영업 문의를 각각 4개씩 만들고 영어와 한국어로 같은 뜻을 적었습니다. 총 24개 입력이며 질문과 선택지 설명은 영어로 유지했습니다. 한국어 문의 분류 실험에서도 state만 한국어이고, 질문과 선택지는 영어입니다.
별도로 언어마다 환불을 요청하는 문장 3개와 요청하지 않는 문장 3개를 만들었습니다. 각 문장에 “환불을 요청하는가?”와 “환불을 요청하지 않는가?”를 따로 물었습니다. 두 질문을 모두 맞힌 경우에만 한 쌍을 맞혔다고 셌습니다. Noul의 yes 확률이 0.5 이상이면 yes로 판정했으며, 결과를 본 뒤 기준을 바꾸지 않았습니다.
| 확인한 작업 | v19 | v21 |
|---|---|---|
| 영어 문의의 담당 분류 | 12 / 12 | 12 / 12 |
| 한국어 문의의 담당 분류 | 12 / 12 | 12 / 12 |
| 영어의 일반 질문과 부정 질문을 모두 맞힌 쌍 | 6 / 6 | 6 / 6 |
| 한국어의 일반 질문과 부정 질문을 모두 맞힌 쌍 | 6 / 6 | 5 / 6 |
참조: 직접 실행한 입력, 원시 응답, 집계와 재현 스크립트
두 모델 모두 단순한 담당 분류는 맞혔습니다. 이 12개 문의는 제가 만든 짧고 명확한 문장이므로, 한국어 업무 전반의 정확도나 실제 고객 문의의 자동 처리율을 추정할 수는 없습니다.
v21에서 정답과 달랐던 입력은 “환불을 요청하는 것이 아닙니다. 비밀번호 재설정을 도와주세요.”였습니다. “고객이 환불을 요청하고 있나요?”에는 yes 확률 0.0739를 반환했습니다. 반대로 “고객이 환불을 요청하지 않고 있나요?”에는 0.4583을 반환해, 미리 정한 0.5 기준에서 no로 분류됐습니다. 같은 부정 질문에 v19는 0.6145를 반환했습니다.
이 한 사례로 v19가 전반적으로 더 낫다고 결론낼 수는 없습니다. 다만 최신 버전으로 바꿀 때 기존 질문의 판정이 유지되는지는 확인해야 합니다. 서로 반대인 두 질문의 확률이 정확히 보완 관계를 이룬다고 가정하는 것도 피해야 합니다. 이번 실험은 확률 보정이나 운영 임계값을 평가할 만큼 크지 않습니다.
참조: 실험 원시 응답의 negation-05-ko 항목
짧은 입력은 약 62-67ms, 긴 입력은 약 265ms였습니다
지연은 내용 이해 실험과 분리했습니다. 같은 영어 문장을 반복해 세 길이의 입력을 만들고, 각 길이에서 3회 워밍업 후 20회씩 순차 실행했습니다. 아래 토큰 수에는 엔진이 렌더링한 state와 질문이 모두 포함됩니다. 모델 엔진 호출 전후에 CUDA 동기화를 적용했으며 HTTP, 네트워크, 동시 요청의 대기 시간은 포함하지 않았습니다.
| 실제 입력 토큰 수 | v19 중앙값 / p95 | v21 중앙값 / p95 |
|---|---|---|
| 132 | 67.3 / 67.5ms | 62.1 / 62.3ms |
| 510 | 70.6 / 70.7ms | 69.7 / 69.7ms |
| 2,049 | 266.2 / 266.3ms | 264.5 / 264.6ms |
참조: 실험의 raw.jsonl 및 summary.json
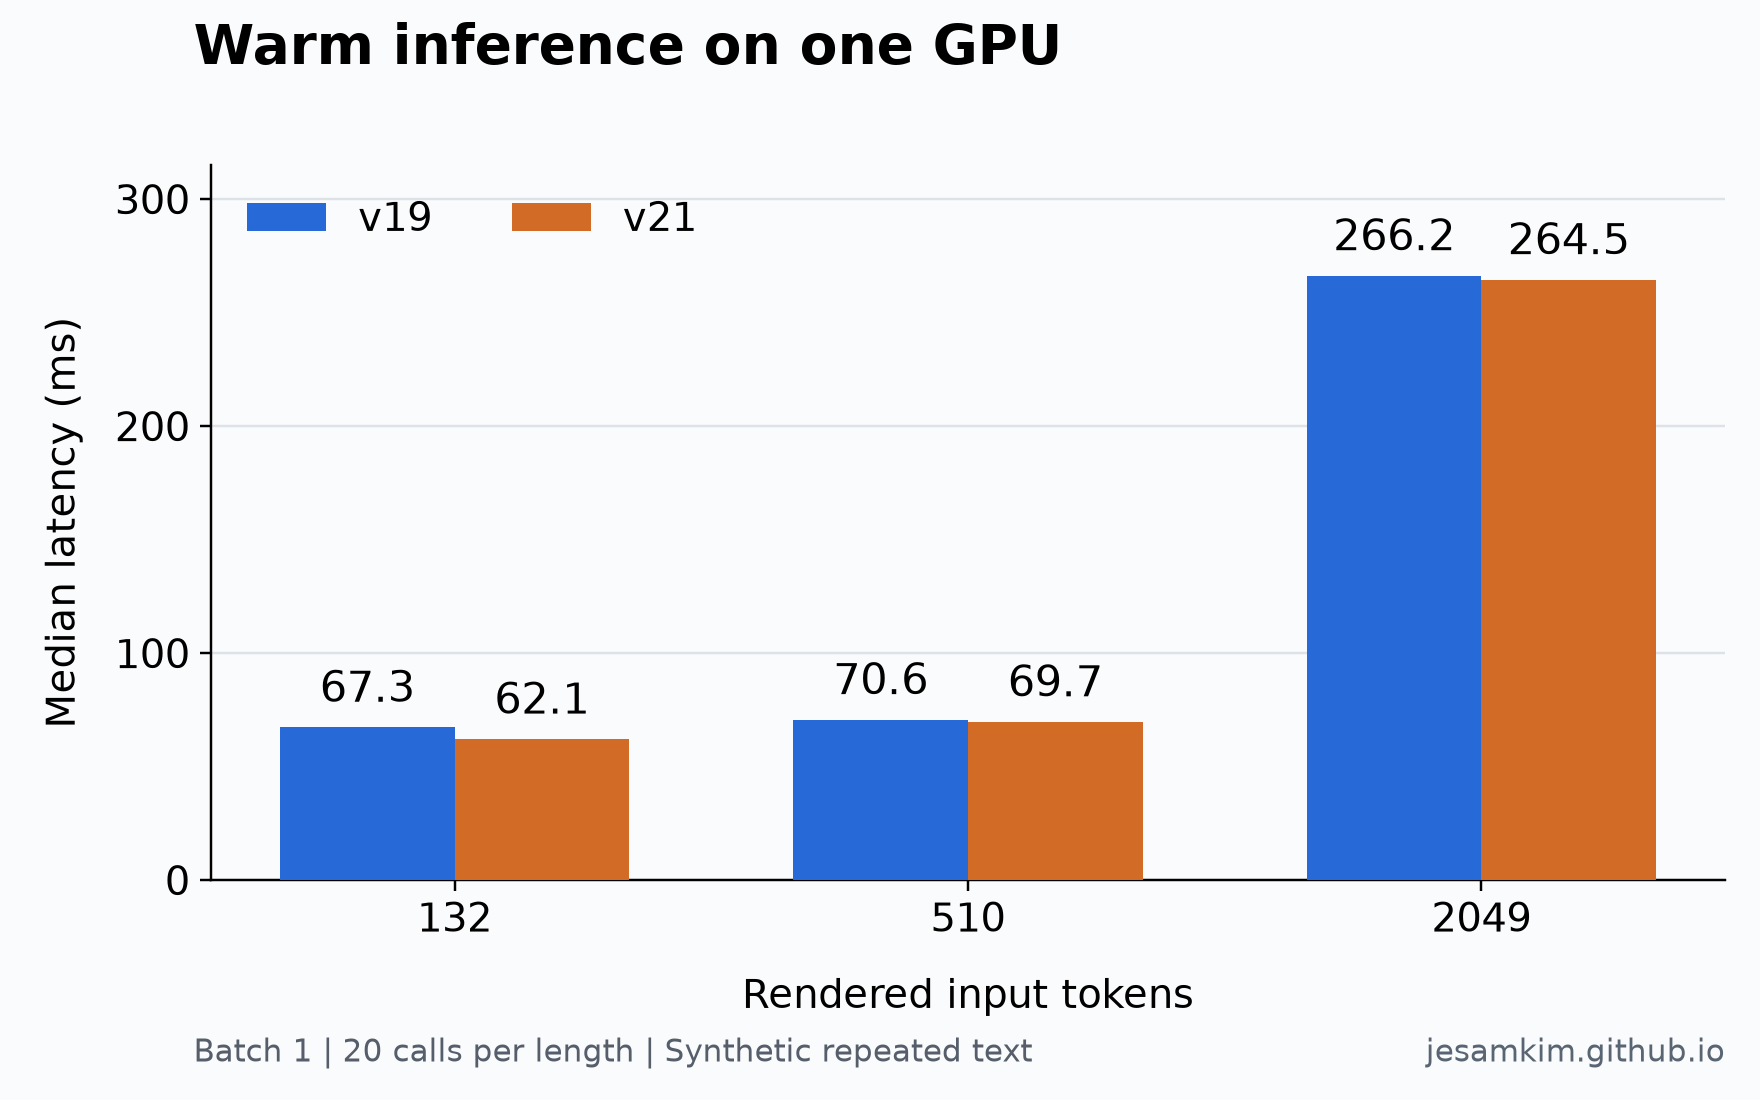
직접 측정한 중앙값입니다. 각 길이에서 같은 합성 입력을 20회 반복한 결과이며, 긴 문서의 이해 능력이나 운영 서비스의 지연을 평가한 그래프는 아닙니다.
이번 실행에서는 두 버전의 지연이 비슷했고 입력이 길어지면 처리 시간이 늘었습니다. 실행 순서는 v19 다음 v21이었으며, 순서를 바꿔 여러 번 반복하는 통제 실험은 하지 않았습니다. 20회의 p95는 이 실행에서 관찰한 값으로, 운영 환경의 지연 상한을 뜻하지 않습니다.
첫 요청은 워밍업 후와 크게 달랐습니다. v19의 모델 로드는 약 3.65초, 로드 후 첫 요청은 초기 커널 컴파일 등을 포함해 약 33.07초였습니다. 이후 별도 프로세스에서 실행한 v21은 첫 요청에 약 0.95초가 걸렸지만, v19가 만든 디스크의 컴파일 캐시를 재사용할 수 있는 상태였습니다. 두 값을 버전별 콜드 스타트 성능으로 비교할 수는 없습니다. 짧은 요청에 빠르게 응답하려면 모델을 메모리에 계속 올려둘지, 시작할 때 워밍업할지 정해야 합니다.
실험 코드와 원시 결과
실험 자료 ZIP에는 고정한 입력과 정답, 실행 전 해시, 모델 revision, 실행 스크립트와 라이브러리 목록, 원시 응답과 지연 기록을 담았습니다. 모델 가중치는 포함하지 않았습니다. 압축을 푼 뒤 README의 환경 준비 절차를 따르면 고정된 모델을 내려받아 다시 실행할 수 있습니다.
.venv/bin/python download_models.py
.venv/bin/python run_probe.py --model v19
.venv/bin/python run_probe.py --model v21
자료에는 측정이 끝난 뒤 추가한 검사를 별도로 표시했습니다. 첫 v19 실행 스크립트를 보존하고, 당시 불러온 소스와 커밋이 계획과 일치하는지 확인했습니다. 입력, 정답, 측정값은 그대로 두었습니다.
Strands 연동 예제와 서비스 배포 시 확인할 점
공식 Strands 예제는 날씨 도구를 호출하기 직전에 Decider로 두 가지를 확인합니다. 도구 인자가 사용자가 제공한 정보에 근거하는지, 사용자에게 더 묻지 않고 도구를 호출해도 되는지 판단합니다. before_tool_call에서 실행하는 코드가 이 결과에 따라 도구 호출을 진행하거나, LLM이 사용자에게 추가 질문을 하도록 합니다.
이 예제의 질문과 임계값은 설명을 위해 수동으로 정한 값입니다. 실제 업무에 적용하려면 누락된 인자를 잡는 비율과 정상 호출을 잘못 막는 비율을 함께 평가해야 합니다. 모델이 허용하더라도 실행할 수 있는 도구와 데이터의 범위는 애플리케이션 권한 검사로 제한해야 합니다.
Decider의 기본 HTTP 서버는 127.0.0.1에 바인딩하며 인증이 없습니다. 문서는 동시 요청 동작도 검증하지 않았다고 밝힙니다. 따라서 이 서버를 그대로 외부에 열기보다 로컬 실험에서 시작하고, 운영 배포 시에는 인증, 요청 제한, 오류 처리와 동시성 검증을 별도로 준비해야 합니다. AWS에 배포한다면 비공개 네트워크와 최소 권한을 적용하고, 외부 접근이 필요한 경우에도 HTTPS와 인증을 갖추는 방식이 적절합니다.
모델을 직접 배포하고 수정하거나 재학습해야 한다면 Decider를, GPU 서버 관리 없이 API로 사용하려면 Jev를 검토할 수 있습니다. 실제 적용 여부는 같은 업무 데이터로 판단해야 합니다. 예를 들어 고객 문의를 자동으로 분류한다면 잘못 배정한 비율을 측정하고, 확신이 낮을 때 사람이 검토하도록 할지 정해야 합니다.
References
- Strands Agents, Introducing Strands Decider 2B, 2026-10-01
- Strands Decider 공개 저장소, 본문이 참고한 커밋
- Strands Decider 아키텍처
- Strands Decider 추론과 서빙
- Strands Decider 평가와 한계
- Strands Decider v19 모델 카드
- Strands Decider v21 모델 카드
- Strands 도구 호출 개입 예제
- TypeSafe, Models
- TypeSafe, Confidence
- TypeSafe, Machine learning primer
- TypeSafe, WorkflowEvals
- TypeSafe, Workflow evaluations