검색 도구를 호출하는 에이전트를 생각해 보겠습니다. 검색 요청이 완성되면 다음 판단에 필요한 것은 검색 결과입니다. 그런데 생성기가 그 뒤의 텍스트까지 계산하고 실행 환경은 그 내용을 버린다면, 계산을 많이 했어도 작업에는 도움이 되지 않습니다. 이 상황은 설명을 위한 예시입니다.
앞서 Prefix-aware Routing 글에서는 이미 계산한 입력을 재사용할 서버를 선택하는 문제를 다뤘습니다. 이번에는 생성 중인 응답 안에서 어떤 계산을 계속할지 살펴보겠습니다.
토큰 확정과 계산 범위를 함께 조절합니다
Diffusion 언어모델을 이해하는 출발점은 아직 정하지 않은 토큰 위치를 여러 번 예측하며 채워 간다는 점입니다. 여러 위치를 병렬로 처리할 수 있지만, 반복 계산이 필요합니다. 블록 단위 생성에서는 이런 작업을 일정한 구간 안에서 수행합니다. 따라서 병렬 생성에서도 계산 횟수와 계산할 위치의 수를 함께 살펴봐야 합니다.
Mingyu Zhao 등의 Metacognitive Decoding은 2026년 10월 27일 UTC에 제출된 프리프린트입니다. Diffusion 에이전트에 컨트롤러를 붙여 어느 토큰을 확정할지와 어디까지 계산할지를 조절합니다. Confidence Alignment는 구조 패턴과 토큰 수락을, Flux는 활성 범위를 제어합니다. 줄인 범위가 부족하면 다시 확장합니다. 대상 과제에 SFT한 LLaDA-8B backbone을 고정한 뒤 컨트롤러를 학습하므로, 학습 없는 최적화는 아닙니다. 컨트롤러는 전체 상호작용의 정답 여부와 추론 연산량을 반영한 보상으로 학습합니다.
참조: 논문 v1, §3 및 §4.1, 제출 정보
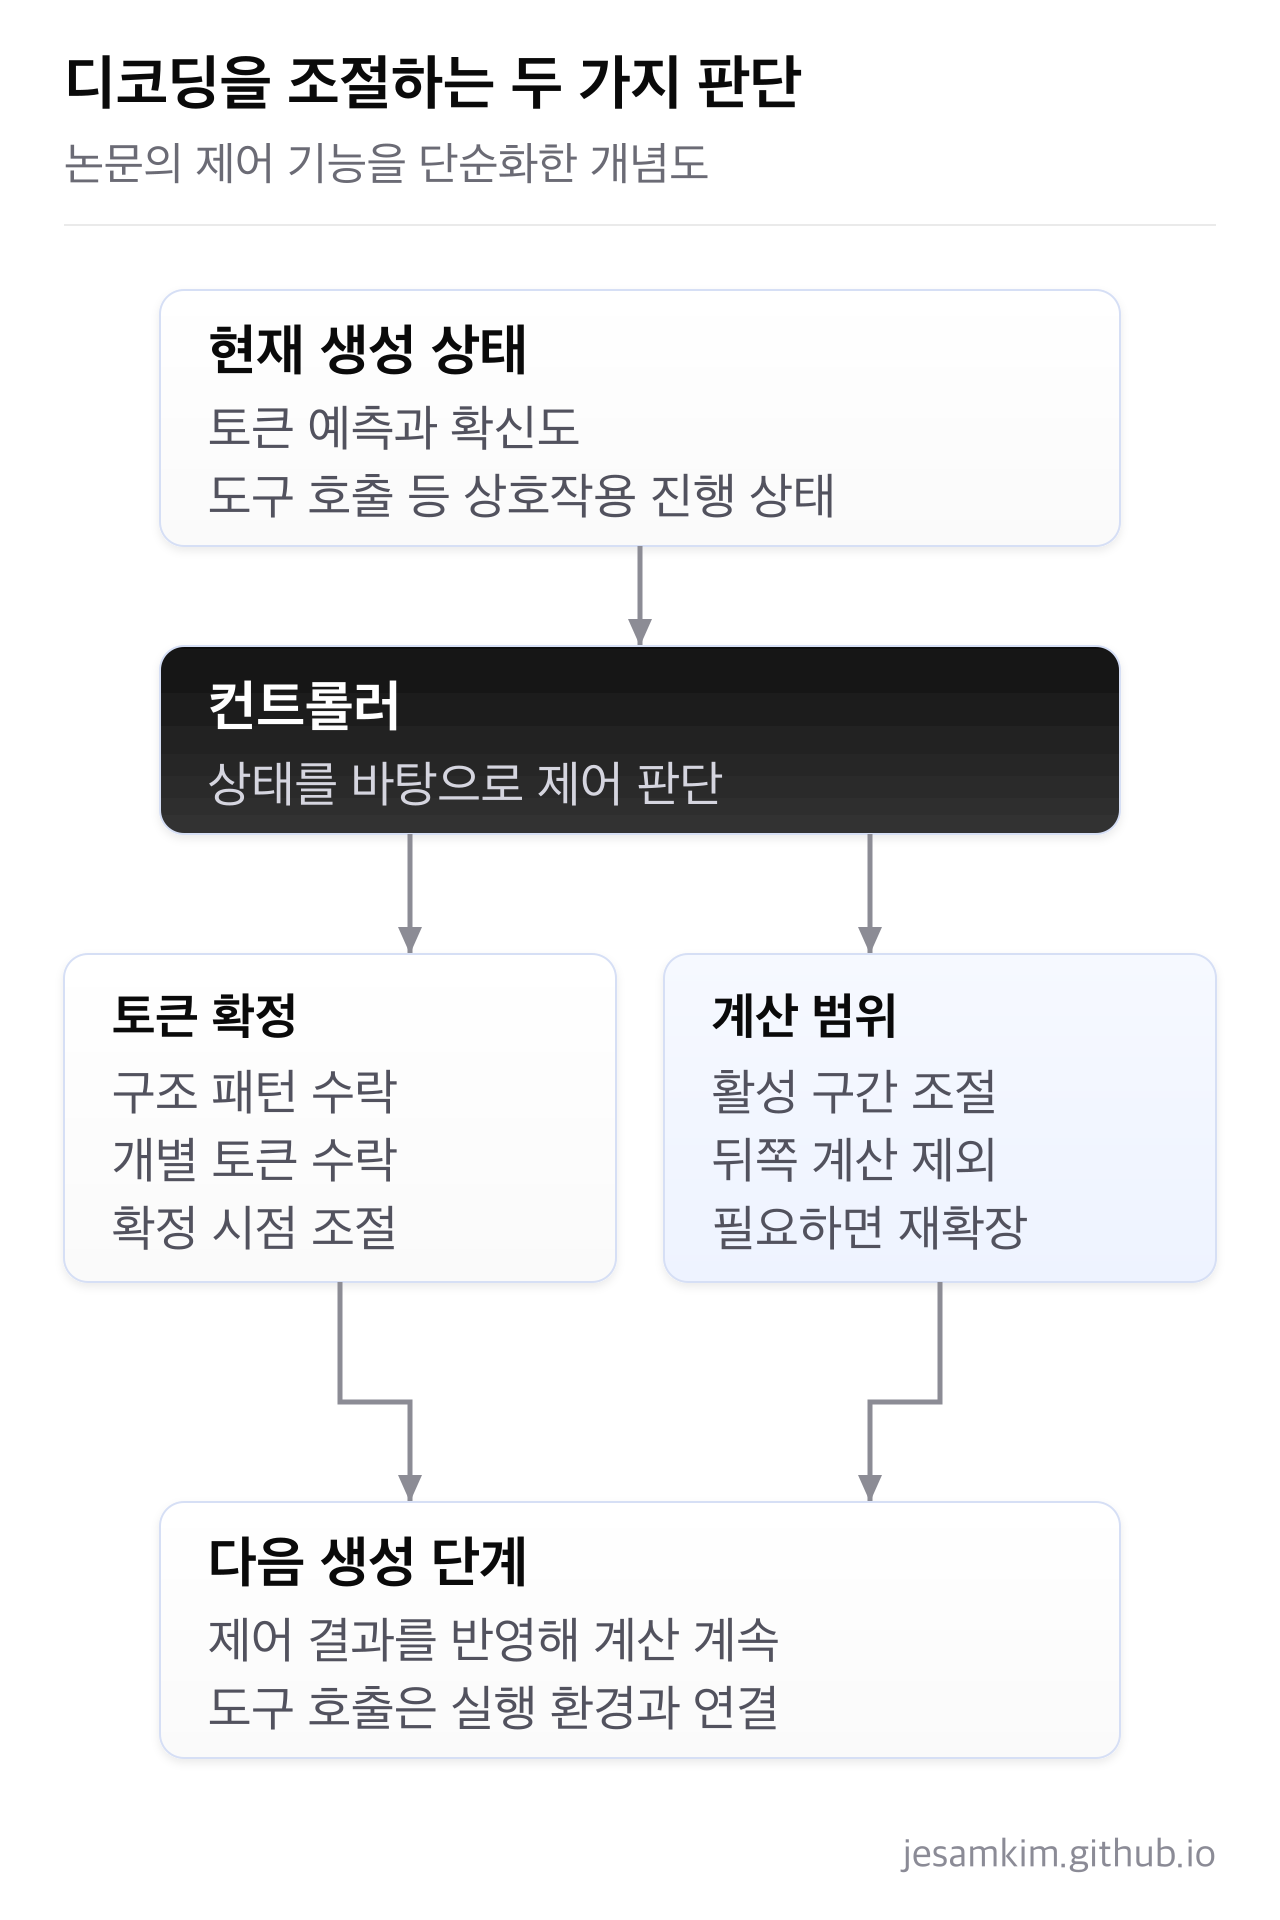
논문의 두 제어 기능을 단순화했습니다. 메타인지는 여기서 생성 상태를 이용하는 제어 기능을 가리킵니다.
참조: 논문 §3
이 구분을 이해하려면 답변 길이와 계산 범위를 따로 생각하는 편이 좋습니다. 예를 들어 작성 중인 양식에 빈칸이 여럿 있다고 가정해 보겠습니다. 이미 확실한 항목을 확정하는 것과 당장 필요 없는 뒤쪽 항목의 작업을 미루는 것은 서로 다른 판단입니다. 나중에 추가 항목이 필요하면 다시 작업할 수 있어야 합니다. 이 비유는 제어 대상을 설명하기 위한 것이며, 실제 구현이 문서 양식을 처리한다는 뜻은 아닙니다.
따라서 이 연구를 “답변을 짧게 만들어 비용을 줄인다”로 소개하면 제어 대상이 잘 드러나지 않습니다. 독자가 살펴볼 부분은 확정 시점과 계산 범위를 바꿨을 때 결과의 품질까지 어떻게 달라지는가입니다.
20.6%의 비교 기준을 확인합니다
BFCL은 도구 호출을 평가합니다. 세 QA 과제는 정답이 출력에 포함되는지 보는 CEM 지표를 사용합니다.
Table 1에서 각 항목의 최소 FLOPs 기준선을 골라 감소율을 평균하면 20.598%, 약 20.6%가 됩니다. 동일한 모델 하나를 기준으로 한 평균은 아닙니다. 아래는 표의 값을 재계산한 결과입니다.
| 평가 항목 | 최소 FLOPs 기준선 | 감소율 |
|---|---|---|
| BFCL Live | LLaDA-8B (SFT) | 43.12% |
| BFCL Non-live | LLaDA2.0-mini | 11.40% |
| HotpotQA | LLaDA2.0-mini | 7.16% |
| 2Wiki | LLaDA2.0-mini | 26.13% |
| MuSiQue | LLaDA2.0-mini | 15.17% |
정확도는 항상 유지되지 않습니다. BFCL Non-live는 해당 기준선의 79.42%에서 65.47%로 낮아집니다. 같은 SFT backbone과 비교해도 MuSiQue는 20.70%에서 20.30%로 낮아집니다. FLOPs는 컨트롤러를 포함한 전체 상호작용의 주요 행렬 연산량이며, 응답시간이나 청구액이 아닙니다.
참조: 논문 Table 1과 §4.1
이 수치를 서비스에 적용할 때는 평균보다 먼저 과제별 품질 기준을 정하는 것이 좋겠습니다. 예를 들어 도구 호출의 정확도가 중요한 서비스라면, 계산량이 가장 작은 설정을 바로 채택하기보다 허용할 오류율을 먼저 정하고 그 조건을 만족하는 설정끼리 비용을 비교해야 합니다. 이는 논문의 실험 결과와 구분되는 운영상의 제안입니다.
또한 감소율을 평균할지, 전체 요청의 연산량을 합쳐 비교할지도 실제 트래픽에 맞춰 선택해야 합니다. 요청이 많이 들어오는 과제가 무엇인지에 따라 서비스에서 체감하는 효과가 달라질 수 있습니다. 벤치마크 평균을 운영 비용 예측치로 그대로 사용하는 것은 피해야 합니다.
공개 코드로 확인할 수 있는 범위
저자 저장소에는 SFT, 컨트롤러 학습, BFCL 추론 코드가 있습니다. 다중 홉 QA 인터페이스는 현재 버전에 포함되지 않았다고 명시합니다. 실행에는 호환되는 backbone과 컨트롤러 체크포인트, 학습 때 사용한 구조 템플릿이 필요합니다.
특히 README의 total_flops는 논문 표의 집계와 다릅니다. 공개 구현은 2P × processed positions + controller cost로 추정하며, 논문의 최종 표는 행렬 연산을 집계했다고 설명합니다. generation_seconds도 모델 로딩과 채점을 제외한 생성 시간입니다. 이번 글에서는 원문과 표, 공개 README를 확인하고 수치를 재계산했으며, 모델 학습과 추론 실험을 재현하지는 않았습니다.
참조: 저자 공개 저장소 README
“코드가 공개돼 있다”는 사실만으로 논문의 모든 결과를 같은 조건에서 얻을 수 있다고 판단하기는 어렵습니다. 실제 검증을 시작한다면 코드 버전과 체크포인트, 데이터, 평가기, 연산량 집계 방식부터 고정해야 합니다. 집계 방식이 다른 숫자를 비교하면 성능 차이와 측정 방식의 차이가 섞입니다.
서비스 도입 판단에 필요한 추가 측정
다음은 이 연구를 운영 환경에서 평가한다면 함께 확인하고 싶은 항목입니다. 논문이 모두 입증한 내용이 아니라, 이 글에서 제안하는 검증 절차입니다.
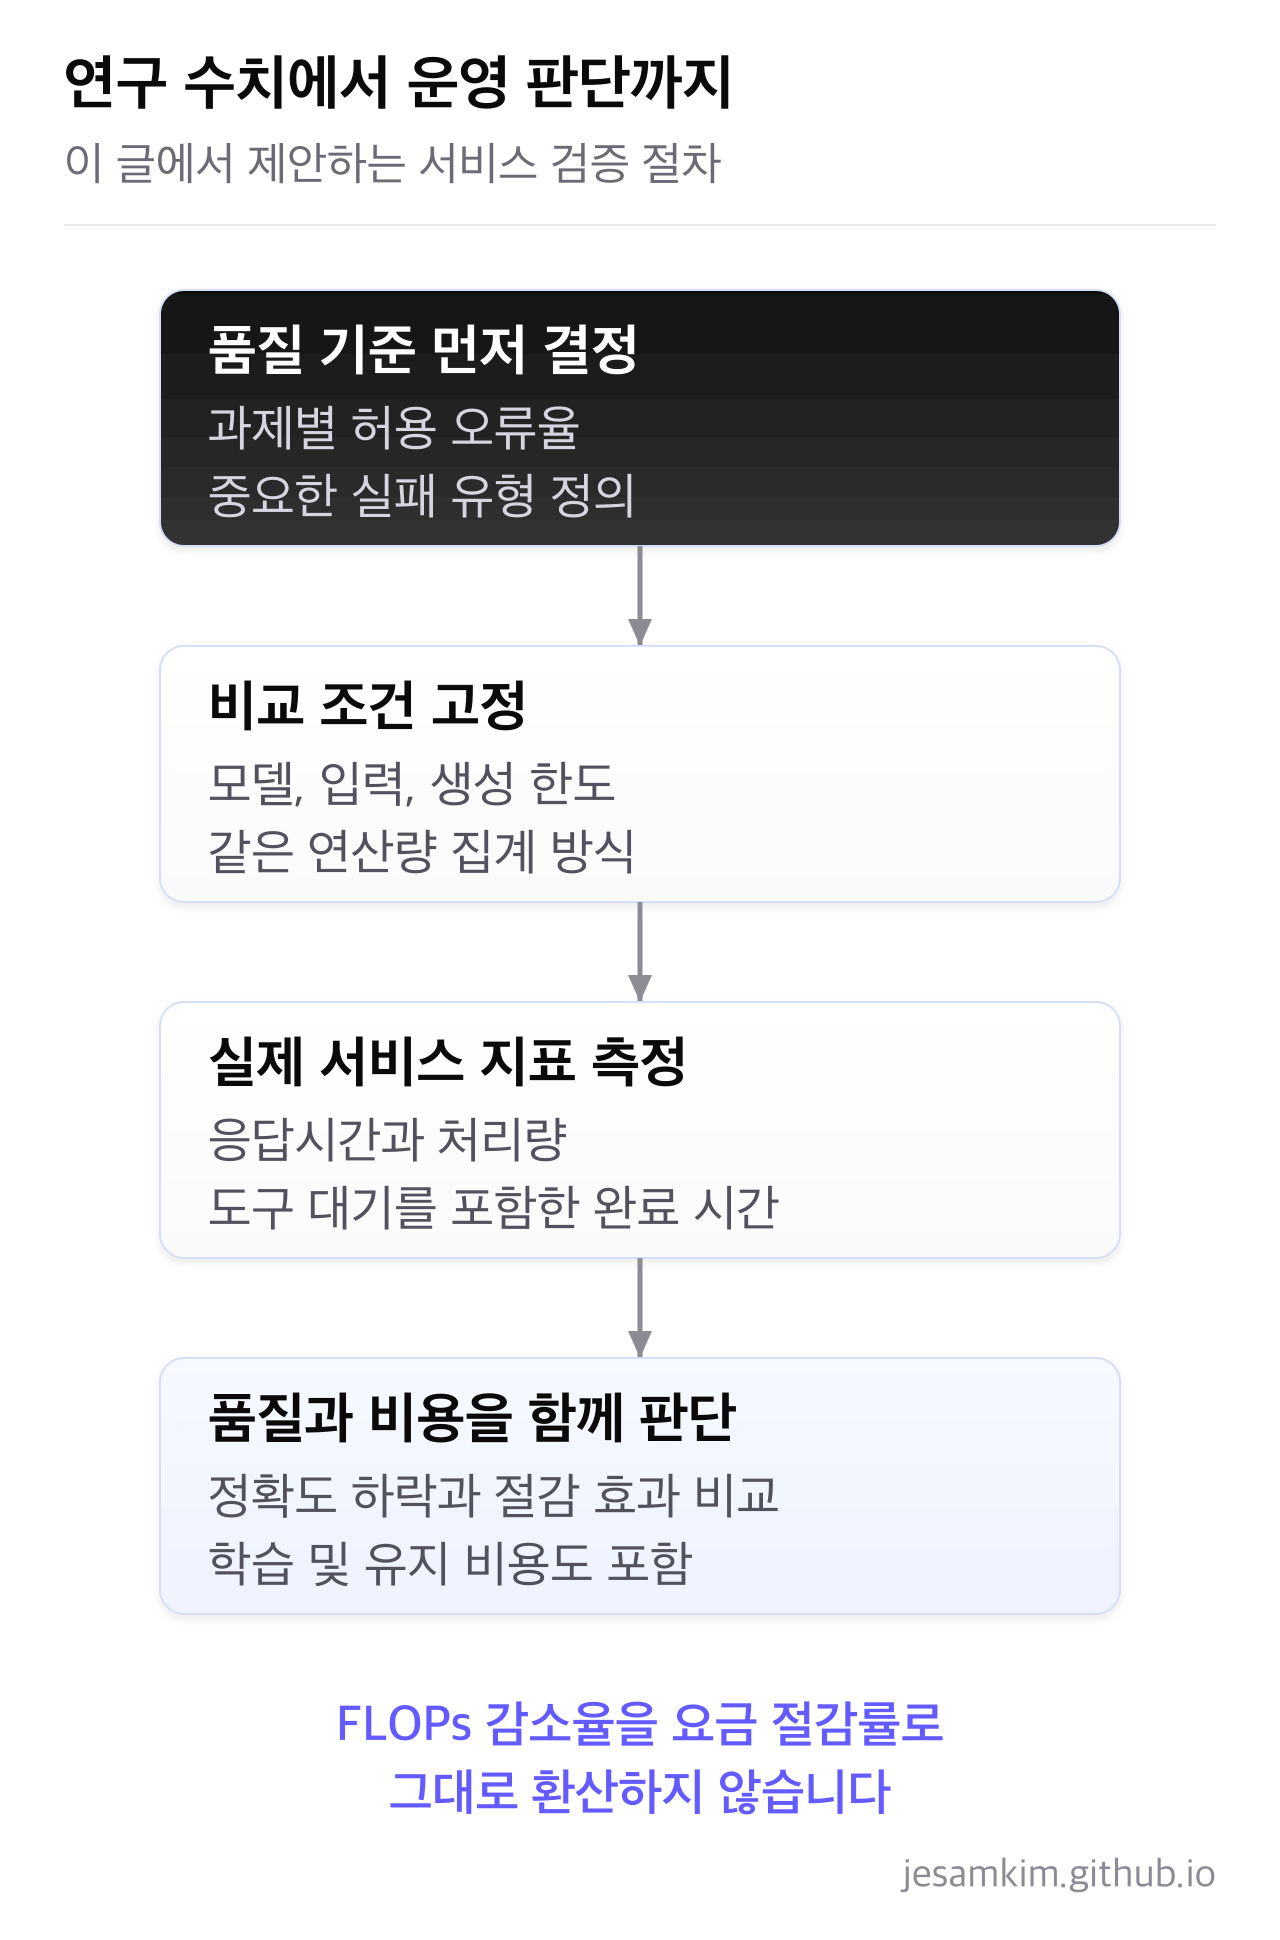
이 글에서 제안하는 서비스 검증 절차입니다.
참조: 논문의 평가 지표, 공개 구현의 측정 범위를 바탕으로 정리했습니다.
| 확인할 항목 | 판단에 필요한 이유 |
|---|---|
| 과제별 정확도와 실패 유형 | 평균 점수가 감추는 도구 호출 오류나 특정 과제의 성능 저하를 확인합니다. |
| 동일 조건의 연산량 | 모델, 입력, 생성 한도와 집계 방식을 맞춰 제어 기능의 효과를 비교합니다. |
| 실제 응답시간과 처리량 | 연산량이 줄어도 대기와 데이터 이동 등 다른 비용이 남는지 확인합니다. |
| 도구 대기 포함 완료 시간 | 생성이 빨라진 만큼 사용자 작업도 빨리 끝나는지 확인합니다. |
| 학습 및 유지 비용 | 과제와 형식이 바뀔 때 다시 준비할 데이터와 검증 작업을 고려합니다. |
특히 모델 생성 시간이 전체 작업 시간의 일부에 불과한 서비스라면, 디코딩 개선만으로 얻을 수 있는 효과에도 한계가 있습니다. 도구 응답을 기다리는 시간이 길다면 그 시간을 따로 측정해야 합니다. 반대로 생성 과정이 대부분을 차지한다면 디코딩의 작은 개선도 검토할 가치가 있습니다. 어느 쪽인지는 서비스의 관측 자료로 판단해야 합니다.
이 논문에서 출발해 던질 운영 질문은 구체적입니다. 현재 생성 과정에서 실제 작업에 사용되지 않는 계산은 어디에 있고, 그 계산을 줄였을 때 어떤 품질을 잃는가. 연산량과 정확도, 실제 완료 시간을 함께 비교하면 새 디코딩 기법의 적용 가능성을 더 분명하게 판단할 수 있습니다.